「障害発生時、監視ツール・チャット・ターミナル・手順書を何度も行き来して対応が遅れる」 「誰がどのサーバーにログインして、どんなコマンドを実行したのかがチーム内で共有できていない」
クラウド化やリモートワークが定着した現代のIT運用現場では、日々のコミュニケーションの中心がSlackやMicrosoft Teamsなどのビジネスチャットへと移行しました。
しかし、いざサーバー操作や障害対応となると、「チャットで連絡を取り合いながら、別の黒い画面(SSHやリモートデスクトップ)を開いて個別に作業する」という分断された運用がいまだに多く残っています。
このギャップを埋め、普段使っているチャットツール上から直接サーバー操作や運用自動化を実行する手法が「ChatOps(チャットオプス)」です。
本記事では、ChatOpsの基本的な仕組みから、導入によって得られる具体的なメリット、セキュリティを担保しつつスモールスタートで始める導入ステップまでを分かりやすく解説します。
「ChatOps(チャットオプス)」とは?今注目される背景
ChatOps(チャットオプス)とは、「Chat(チャット)」と「Operations(運用)」を組み合わせた造語で、ビジネスチャットを起点に、システム監視・サーバー操作・デプロイ・障害対応などの運用業務を一元的に実行する手法を指します。
もともとはGitHub社が社内運用(Hubotの活用)で実践したことから広まり、現在ではSRE(サイト信頼性エンジニアリング)やDevOpsを取り入れる企業を中心に、インフラ運用のスタンダードなアプローチとして注目されています。
ツール間の「コンテキストスイッチ」が生産性を奪っている
ChatOpsが求められる背景には、運用現場における「ツールの乱立」と「情報の分断」があります。
米国の調査機関(Qatalog社やCornell大学の共同研究など)のレポートでも、従業員が業務中に異なるアプリケーションや画面を何度も切り替える(コンテキストスイッチを行う)ことで集中力が削がれ、作業完了までの時間が大幅に増加することが指摘されています。
特に緊急のシステム障害対応では、以下のような煩雑な動きが発生しがちです。
1.監視ツールからアラートメールが届く
2.チャットツールでチームメンバーに状況を共有する
3.VPNに接続し、踏み台サーバー経由で対象サーバーへログインする
4.調査コマンドを実行し、結果をコピーしてチャットに貼り付ける
5.別のメンバーが復旧コマンドを実行し、またチャットで報告する
このように「連絡する場所」と「作業する場所」が離れていると、対応のタイムラグや情報伝達ミス、さらには「二人が同時に同じサーバーを操作してしまう」といった事故の原因になります。
Slack・Teamsから運用操作を行う4つのメリット
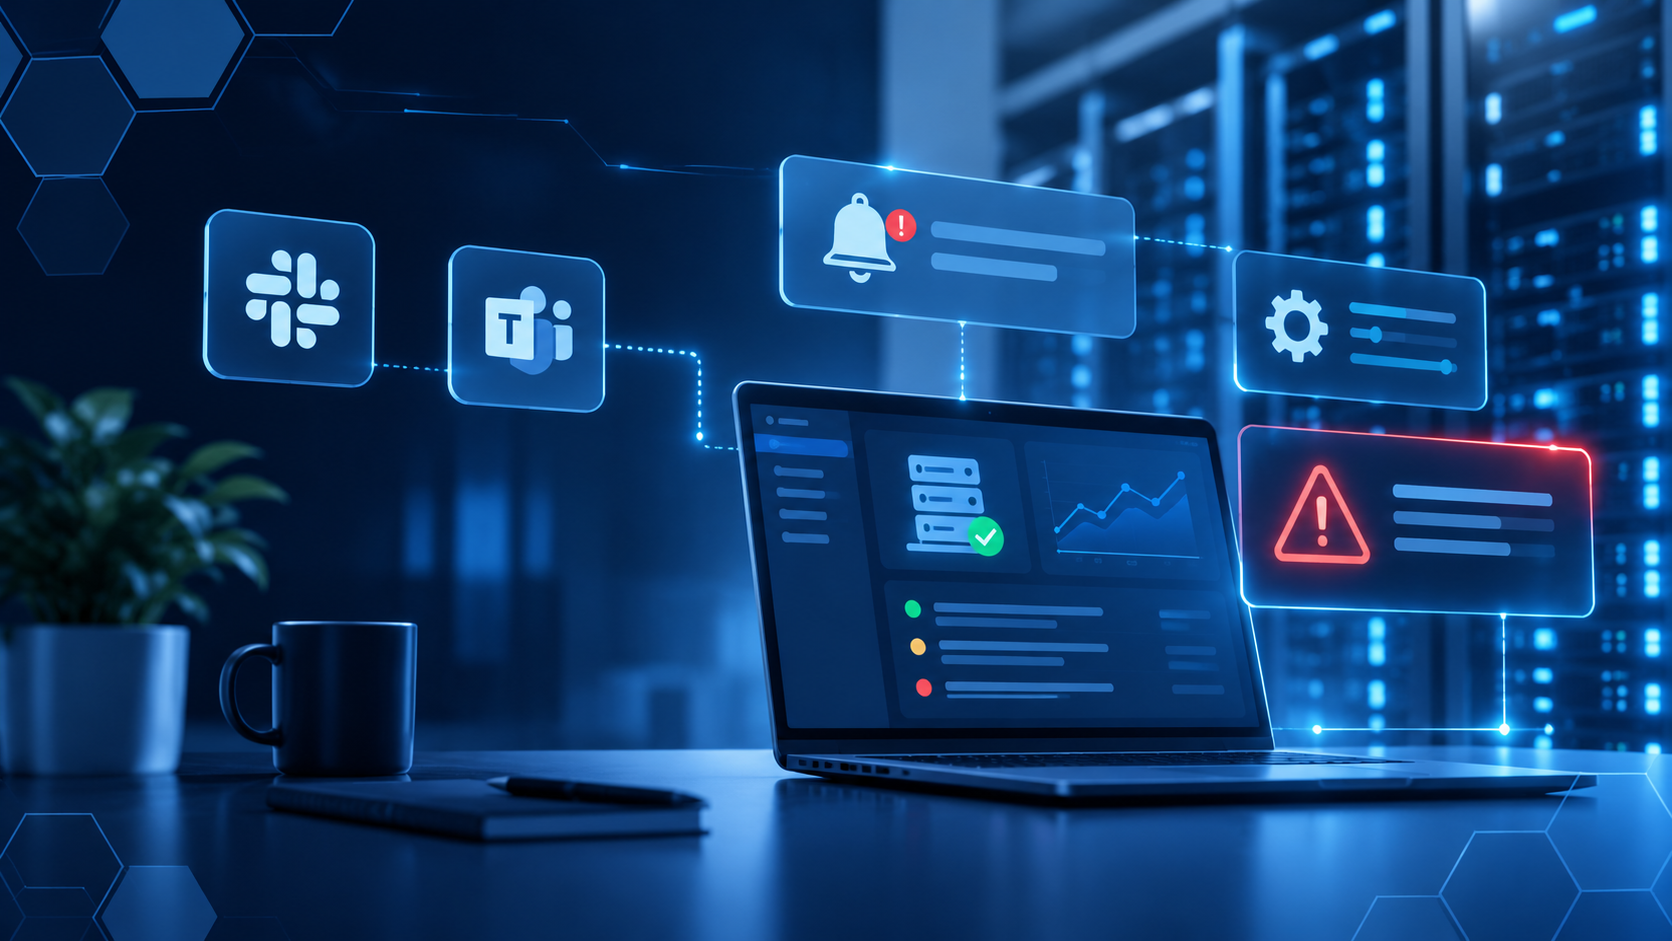
ChatOpsを導入し、チャットボットや運用自動化ツールを通じてSlack・Teams上からサーバー操作や一次対応を行えるようにすると、現場には4つの大きなメリットが生まれます。
1. 障害対応スピード(MTTR)の劇的な向上
監視ツールからのアラート通知をチャットチャンネルに集約し、そのスレッド上で直接「ログ取得」や「サービス再起動」のコマンド(またはボタン操作)を実行できるようになります。
担当者がわざわざPCのターミナルを立ち上げてサーバーへ個別にログインする手間が省けるため、アラート検知から一次切り分け・復旧までの時間(MTTR:平均復旧時間)を大幅に短縮できます。
外出先や移動中でも、スマートフォンのチャットアプリから安全に初期対応を指示することも可能です。
2. 作業履歴の「自動記録」と「透明性の確保」
チャットチャンネル上で「誰が・いつ・どのサーバーに対して・どんな操作を実行し・どんな結果が返ってきたか」がすべてタイムライン上に記録されます。
従来の「個人のPC内のターミナルで作業する運用」では、後から振り返ろうとしても作業ログが個人の端末にしか残らないという課題がありました。
ChatOpsであれば、チャットそのものが改ざんされにくいリアルタイムの作業証跡(監査ログ)となり、チーム全員が同じ画面を見ながら状況を把握できるため、二重作業や認識の齟齬を防げます。
3. 属人化の解消とナレッジの自然な共有
ベテランエンジニアがチャット上で実行している調査コマンドや復旧手順を、若手メンバーもリアルタイムで見ることができます。
「こういうアラートが鳴ったら、このコマンドで切り分けるのか」という生きたノウハウが日々のチャット履歴に蓄積されるため、OJTや教育コストの削減にもつながります。
さらに、複雑なコマンドをそのまま打つのではなく、定型化された「実行ボタン」や「簡易コマンド」としてチャットボットに組み込んでおけば、経験の浅いメンバーでも安全にオペレーションを実行できるようになります。
4. コマンド打ち間違いによるヒューマンエラーの防止
緊急時の焦りや寝起きの状態で直接サーバーにSSHログインすると、オプションの指定ミスや対象サーバーの取り違えといった致命的なオペレーションミスが起きやすくなります。
あらかじめテスト済みの安全なワークフローをChatOps経由で呼び出す仕組みにしておけば、人間が直接サーバーのシェルを触る機会を減らし、ヒューマンエラーを構造的に防止できます。
安全かつスムーズに始めるChatOps導入の4ステップ
ChatOpsは便利な一方で、「チャットから誰でもサーバーを操作できてしまうとセキュリティが危険ではないか?」という懸念もよく聞かれます。
失敗なく安全に導入するための4つのステップをご紹介します。
ステップ1:まずは「通知の集約」と「参照系操作」から始める
最初からサーバーの再起動や設定変更といった「更新系・破壊系」の操作をチャットに開放する必要はありません。
まずは、監視ツールからのアラート通知をチャットに集約すること、そしてサーバーのステータス確認やログ取得といった「参照系(読み取り専用)のコマンド実行」からスタートしましょう。
これだけでも一次切り分けのスピードは格段に上がります。
ステップ2:定型的な運用手順を自動化する
次に、チャットから呼び出すための「定型オペレーション(Runbook)」を整備します。
たとえば、「特定のWebサービスを再起動する」「ディスク容量を圧迫している古いログを削除する」「特定IPからのアクセスを遮断する」といった頻度の高い作業を、運用自動化ツール側でワークフロー化しておきます。
ステップ3:権限管理(RBAC)と承認フローを組み込む
セキュリティを担保するために最も重要なのが、実行権限のコントロールです。
- チャンネル・ユーザー制限: 操作コマンドを実行できるチャンネルを限定し、特定の権限を持つメンバー(ロール)のみが実行できるように制限します。
- 承認(ダブルチェック)フローの実装: 本番環境のサーバー再起動など影響の大きい操作については、チャット上で実行リクエストを出した後、マネージャーや別担当者がチャット上の「承認ボタン」を押して初めて実行される仕組み(ヒューマン・イン・ザ・ループ)を組み込むことで、誤操作や不正操作を防ぎます。
ステップ4:運用ルールを定着させ、対象業務を広げる
導入後は、定期的な障害訓練や振り返りを通じて「操作は必ずチャット経由で行う」という文化を定着させます。
現場が慣れてきたら、アカウント発行や定期メンテナンスなど、インフラ以外の情シス定型業務へと適用範囲を広げていきましょう。
Slack / Teams連携で運用自動化を実現する「ロボシュタイン」
「チャットツールから安全にサーバー操作や一次切り分けを実行したい」 「自作のチャットボットをゼロから開発・保守する工数までは割けない」
そんな運用現場のニーズに最適なのが、株式会社コムスクエアが提供するIT運用自動化サービス「ロボシュタイン(Robostein)」です。
ロボシュタインは、監視ツールやビジネスチャットと柔軟に連携し、障害検知から一次切り分け、復旧アクションまでを自動化するプラットフォームです。
- SlackやMicrosoft Teamsとのシームレスな連携: 普段お使いのチャットツールをインターフェースとして、アラート通知の受け取りから、調査ログの自動取得、復旧ワークフローの実行指示までをチャット上で完結できます。
- ノーコード・GUIで安全なワークフローを構築: プログラミング不要の直感的な画面操作で、条件分岐やエラー処理を含む運用手順を作成可能。特定のエンジニアに依存せず、チーム全体でメンテナンスできる仕組みを作れます。
- 監視ツール「パトロールクラリス」等との強力な相乗効果: 監視基盤からのアラートをトリガーに、ロボシュタインが自動で一次切り分けを行い、その結果をチャットへレポート。担当者はチャット上の報告を確認し、必要に応じて次のアクションを指示するだけのスマートな運用を実現します。
「今のチャット環境を活かして、障害対応のスピードと透明性を高めたい」「属人化したサーバー操作を安全な仕組みに置き換えたい」とお考えの方は、ぜひロボシュタインの公式サイトより詳細資料をご覧ください。